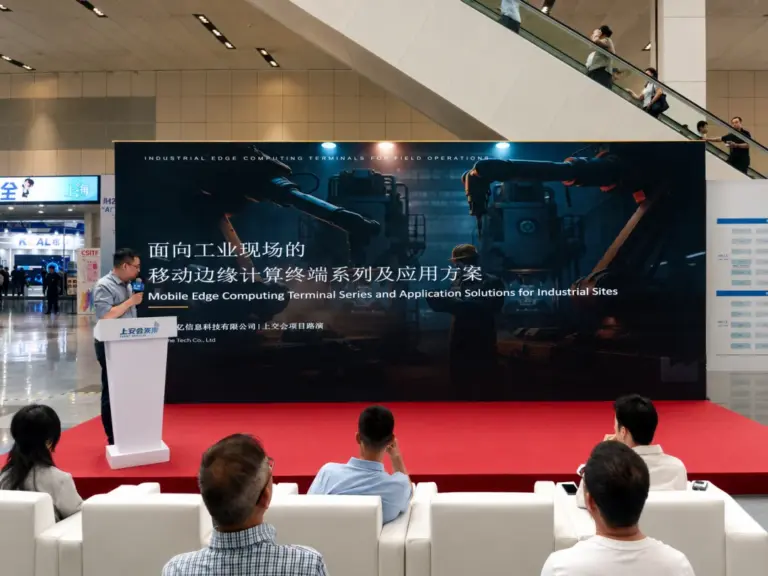
看工业AI演示时,一段流畅的识别视频很容易让人觉得项目已经接近落地。但我更想问的是:换一处光线、换一个班次、摄像头沾上灰尘以后,系统还能否正常工作?演示能够证明某个功能在特定条件下可运行,却不能替代真实现场的长期验证。对工业AI来说,真正难的往往是从“能跑”走到“每天都能用”。
一、演示数据与真实数据存在明显差距
固定样本往往背景简单、目标清晰、光照可控,而工厂现场可能存在粉尘、遮挡、反光、污渍和速度变化。模型在测试集上的识别结果,不能直接代表每个现场的长期效果。项目需要明确样本覆盖了哪些工况、缺少哪些异常,以及真正业务中哪些漏检和误报不可接受。
例如生产线上使用视觉模型检测外观缺陷,如果摄像头位置微调、灯具老化或工件表面反光改变,识别效果可能变化。车辆视频分析还可能遇到夜间逆光、雨雾和镜头污染。部署前需要建立具有代表性的现场数据集,并规划部署后的反馈和复测机制,而不是只检查一次模型推理成功。
我不喜欢把算法准确率当成唯一的项目答案。现场数据的标注标准、异常样本比例、误报处置流程,以及设备维护由谁负责,都会影响最终的业务效果。没有这些环节,再漂亮的演示也可能停留在展台。
二、硬件和数据链路需要工程化
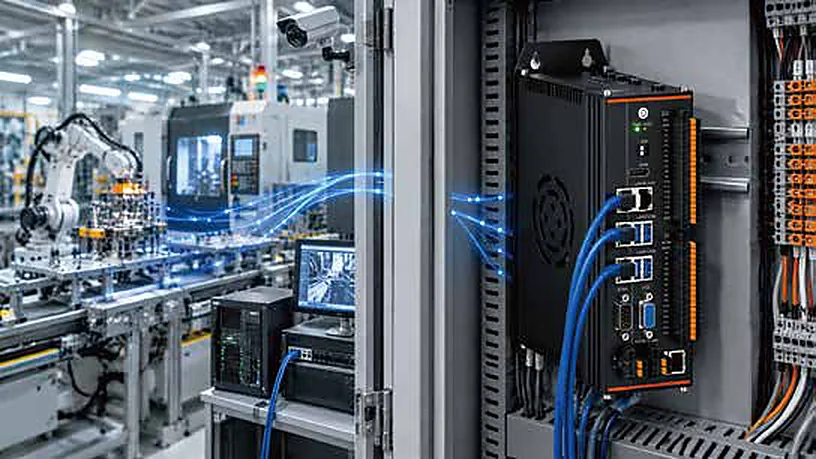
现场边缘计算设备要处理摄像头、传感器、工业网络和电源。相机分辨率、帧率、数据传输和模型处理速度必须匹配;不同设备的时间戳与数据格式也要对齐。若视频输入经常中断、设备频繁重启,算法再准确也不能连续交付结果。
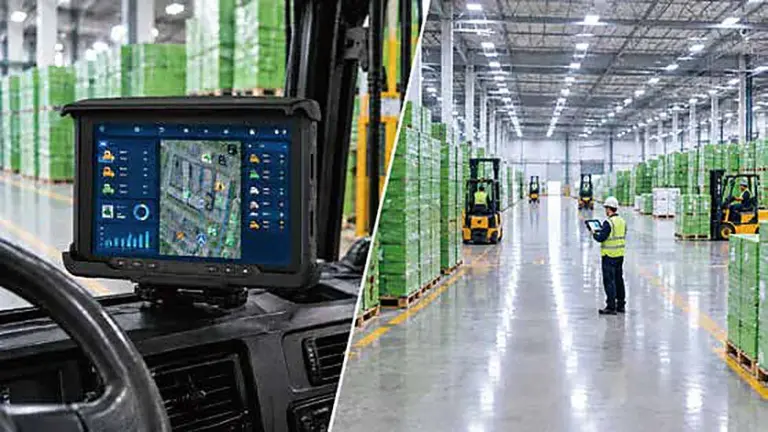
安装位置同样影响最终质量:摄像头振动导致画面抖动,光源角度改变导致反射,边缘计算盒子散热不足导致降频,都会影响系统。面向车辆和室外应用,还要考虑宽压、瞬态干扰和线束固定。工业AI实际是一套“采集—计算—判断—反馈”的系统链路,而不是单一推理芯片。
三、模型上线之后仍需要长期维护
工业现场的物料、工艺、设备和操作规则会变化,模型可能需要更新。每一次更新不仅要验证准确性,还要检查与原应用、设备驱动和运行库的兼容性。批量部署时应管理模型版本、软件镜像、参数、日志和远程升级;升级失败必须有可恢复方案,避免影响生产。
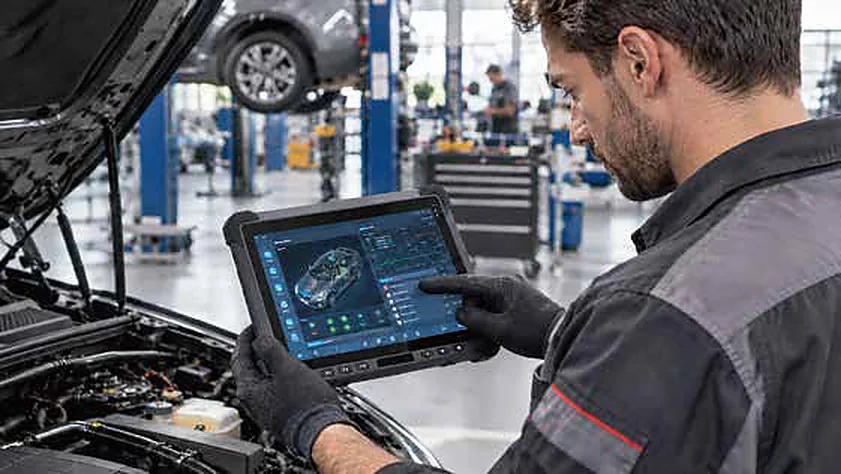
此外,需要明确由谁负责识别误报的复核、异常日志分析、数据标注与后续模型优化。硬件供应商可以提供可用的边缘计算平台,但通常不能单凭硬件规格承诺最终AI效果。项目交付合同最好明确硬件可用性、算法性能、数据权属与维护责任分别由谁承担。
我更倾向于让一线操作人员参与验收。因为识别结果最终要改变人的判断或设备流程:报警是否来得及处理?错误提示是否可理解?出现网络中断时能不能继续工作?这些问题很难只靠研发人员在办公室里回答。
四、从演示走向生产,应设置阶段性验收
第一阶段验证采集和基础算法能否跑通;第二阶段用真实现场的数据进行长时间测试;第三阶段把识别结果接入业务流程,明确人机复核、异常处理和系统失效后的退化方式;第四阶段在少量真实工位或车辆上试运行,再扩展到批量部署。
评价指标不应只有推理帧率,还包括误报率、漏报率、处理延迟、可用性、维护时间和工艺收益。对安全辅助类应用,还要明确提示的作用和责任边界,不能以“AI检测”替代必要的安全制度和工程保护。
为什么要让现场人员参与验收
模型工程师可能关注检测精度,设备工程师关注温度和算力,工厂负责人则关心产线是否因此停机。三方如果不在项目初期约定验收口径,很容易出现“算法已经完成,但业务不敢使用”的局面。尤其对于需要人工复核的应用,应提前定义系统如何呈现置信度、如何标记疑难样本,以及哪些结果必须由人员确认。
项目上线后还要保留一条反馈链:现场识别错误如何上报,数据是否可以用于再次训练,模型更新由谁批准,更新后如何证明原有合格场景未退化。这样的治理并不会让演示更炫目,却决定系统能否从单点试验复制到不同车间、车型或生产批次。
结语
在我看来,工业AI真正的成熟标志不是演示中出现了识别框,而是系统能在变化的现场稳定运行,并且知道发生错误时该怎样处理。数据、设备、算法和维护必须被当作同一个项目来交付。